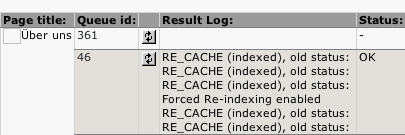
Ich nutze indexed_search mit crawler. Die Queue wird auch völlig korrekt (auch mehrsprachig) gefüllt und indexiert.
Allerdings habe ich das Problem, dass Files (PDF im speziellen) zwar in der Queue landen, aber nicht automatisch indexiert werden.
Im Info-Modul unter Site Crawler -> Crawler log befindet sich das PDF als Eintrag, allerdings im Gegensatz zu den aufgelisteten Seiten ohne Status (-) (s. Anhang Queue id 361. Klicke ich nun bei diesem Eintrag auf "Read" (die rotierenden Pfeile), wird das PDF anstandslos indexiert.
Woran kann es liegen, dass Dateien nicht automatisch indexiert werden?
Danke für Tipps.
Florian